Q-learning : de la table Q à une décision apprise, calcul à l’appui
Le Q-learning est un algorithme d’apprentissage par renforcement : un agent apprend quelles actions choisir en interagissant avec un environnement et en observant leurs récompenses. Il ne mémorise pas seulement ce qui rapporte immédiatement. Il estime aussi ce qu’une action peut rapporter ensuite, afin de construire une stratégie efficace à long terme.
Son mécanisme tient dans une table de valeurs, une règle de mise à jour et un équilibre entre essayer de nouvelles actions et utiliser celles qui semblent déjà intéressantes.
Apprendre une décision plutôt que prédire une étiquette
En apprentissage supervisé, un modèle apprend généralement à partir d’exemples associés à des réponses attendues. En Q-learning, personne ne fournit nécessairement la bonne action à chaque étape : l’agent apprend des conséquences de ses choix. Il peut recevoir une récompense maintenant alors que le bénéfice réel de son action n’apparaît que plusieurs étapes plus tard.
Dans un labyrinthe, l’agent est le personnage, l’état peut être sa position et les actions correspondent aux déplacements autorisés. L’environnement détermine la nouvelle position et la récompense : atteindre la sortie peut être récompensé, tomber dans un piège pénalisé.
- État : information décrivant la situation courante.
- Action : choix accessible à l’agent dans cette situation.
- Récompense : signal numérique reçu après une action.
- Politique : règle utilisée pour choisir une action selon l’état.
Le Q, généralement associé au mot anglais quality, désigne la valeur d’une action dans un état. L’objectif est d’apprendre des valeurs permettant de maximiser la récompense cumulée actualisée, et non de privilégier systématiquement le gain immédiat. Le Q-learning est également dit sans modèle : il n’a pas besoin de connaître à l’avance les probabilités de transition de l’environnement.
La table Q et l’exploration construisent la stratégie
La table Q contient une ligne par état et une colonne par action. Chaque case Q(s, a) représente une estimation du rendement futur obtenu en choisissant l’action a dans l’état s, puis en poursuivant avec les meilleurs choix estimés.
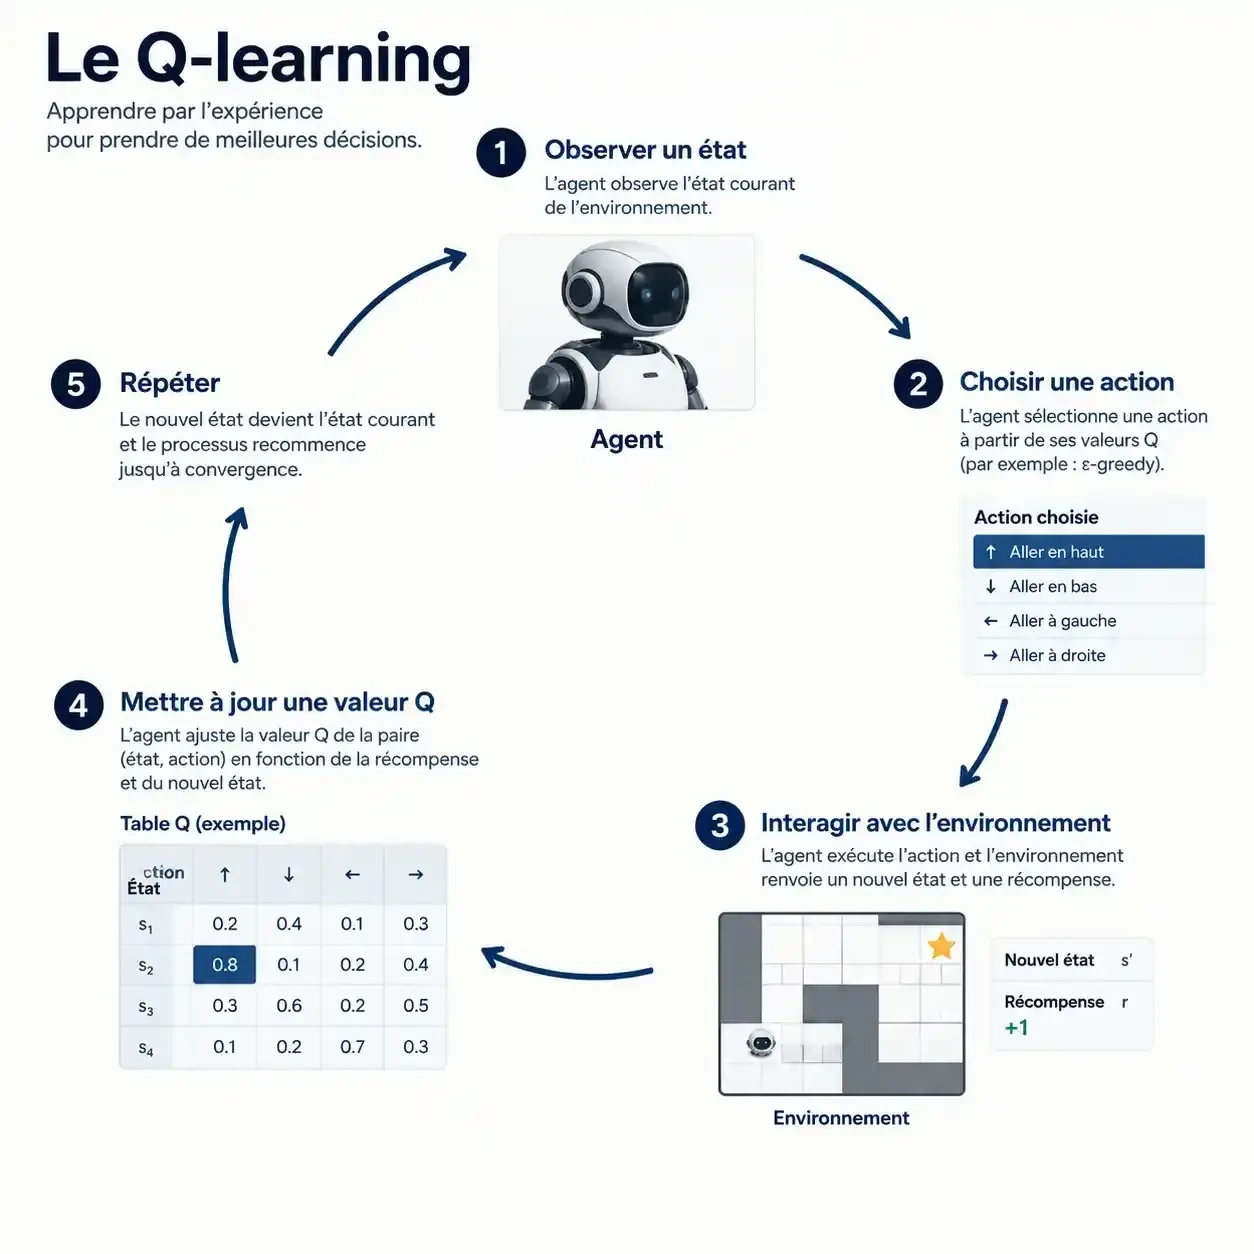
Une initialisation à zéro constitue un point de départ simple. Elle ne signifie pas que toutes les actions sont réellement équivalentes, mais que l’agent ne possède encore aucune estimation permettant de les départager.
Explorer sans renoncer à exploiter
Avec une stratégie epsilon-greedy, l’agent choisit une action aléatoire avec une probabilité ε et sélectionne sinon une action de valeur Q maximale. Pour epsilon = 0,2, comme dans l’exemple de Liora, la branche aléatoire est utilisée dans 20 % des décisions en moyenne. Elle peut d’ailleurs sélectionner elle aussi l’action actuellement jugée meilleure.
On peut comparer une table encore peu explorée à une surface couverte de mousse : une trace visible indique un passage emprunté, pas nécessairement le meilleur chemin. De même, une valeur Q élevée n’est pas une preuve de qualité si les alternatives ont rarement été testées. Pour diagnostiquer l’apprentissage, observer les nombres de visites des paires état-action en complément des valeurs évite de confondre préférence acquise et comparaison réellement menée.
Le Q-learning est hors politique : la politique de comportement peut explorer, tandis que la cible d’apprentissage suppose le meilleur choix estimé dans l’état suivant. C’est ce décalage qui permet d’apprendre une stratégie gloutonne tout en exécutant parfois des actions aléatoires.
La mise à jour Q, expliquée avec un calcul
Après chaque transition, une seule estimation est ajustée à partir de la récompense reçue et de la meilleure valeur du nouvel état :
Q(s, a) ← Q(s, a) + α × [r + γ × max Q(s’, a’) − Q(s, a)]
| Symbole | Rôle dans le calcul |
|---|---|
| s, a | État courant et action exécutée. |
| r, s’ | Récompense observée et état suivant. |
| α, ou lr | Taux d’apprentissage : poids donné à la correction. |
| γ | Facteur d’actualisation des récompenses futures. |
| max Q(s’, a’) | Meilleure valeur estimée parmi les actions suivantes. |
Supposons Q(s, a) = 2, une récompense de 1, une meilleure valeur suivante de 4, α = 0,1 et γ = 0,9. La cible vaut 1 + 0,9 × 4 = 4,6. La nouvelle estimation devient donc 2 + 0,1 × (4,6 − 2) = 2,26. L’agent corrige progressivement sa valeur au lieu de remplacer brutalement son estimation.
À un véritable état terminal, il n’existe plus de récompense future dans l’épisode : la cible se réduit à r. Cette distinction est essentielle dans une implémentation.
Alpha et gamma ne règlent pas la même chose
Avec α = 0, aucun apprentissage n’a lieu. Avec α = 1, l’ancienne estimation est entièrement remplacée par la nouvelle cible. Wikipédia évoque α = 1 dans le cas déterministe ; cela ne constitue pas une recommandation universelle. En environnement stochastique, une transition isolée ne résume pas tous les résultats possibles, d’où l’intérêt de corrections progressives, par exemple avec α = 0,1.
Gamma règle plutôt l’horizon de décision. Liora indique une plage générale de 0,8 à 0,99, à considérer comme indicative : le bon choix dépend de la tâche. Une valeur proche de 1 donne davantage de poids au futur ; gamma nul ne retient que la récompense immédiate.
Passer à Python avec NumPy et Gymnasium
Pour un premier essai, choisissez un environnement Gymnasium aux états et actions discrets, par exemple FrozenLake. NumPy sert à stocker la matrice Q. Une version déterministe facilite l’inspection des déplacements ; une version stochastique permet ensuite d’observer l’effet des transitions incertaines.
Documentation officielle de l’environnement Frozen Lake · Découvrez la documentation Gymnasium de Frozen Lake, un environnement de référence pour expérimenter l’apprentissage par renforcement via une API standardisée.
- Créer l’environnement et lire les nombres d’états et d’actions.
- Initialiser la matrice avec l’instruction Python Q = np.zeros((n_states, n_actions)).
- Au début de chaque épisode, récupérer l’observation avec state, info = env.reset().
- Choisir une action aléatoire selon epsilon, sinon utiliser np.argmax(Q[state]).
- Exécuter env.step(action) et récupérer le nouvel état, la récompense, terminated, truncated et les informations complémentaires.
- Calculer la cible et appliquer la correction Q, puis recommencer depuis le nouvel état.
Ne confondez pas terminaison et troncature. Une terminaison correspond à une fin propre à la tâche. Une troncature peut simplement signaler une limite de temps : elle arrête la collecte de l’épisode, mais ne justifie pas toujours de supprimer la valeur future dans la cible.
Évaluez ensuite la politique sans exploration, sur plusieurs épisodes distincts de l’entraînement. Comparez les récompenses cumulées et le taux de réussite plutôt qu’un seul parcours : un succès isolé peut être dû au hasard.
Reconnaître les limites avant de passer au Deep Q-learning
Le Q-learning tabulaire convient surtout aux espaces discrets de taille maîtrisable. Lorsque les observations deviennent nombreuses ou continues, mémoriser chaque paire état-action devient peu pratique. Le Deep Q-learning remplace alors la table par un réseau neuronal qui approxime les valeurs Q ; il ne supprime toutefois ni le problème d’exploration ni celui des récompenses mal conçues.
La convergence tabulaire repose sur des hypothèses précises : environnement markovien stationnaire, récompenses bornées, exploration suffisante des paires état-action et taux d’apprentissage adaptés. Les garanties classiques demandent notamment des taux dont la somme diverge, mais dont la somme des carrés converge. Un alpha constant ne suffit donc pas à invoquer automatiquement ces garanties.
Enfin, vérifiez ce que vous récompensez. Un agent optimise le signal défini, pas votre intention implicite. Avant d’augmenter le nombre d’épisodes ou de changer d’algorithme, contrôlez la représentation des états, les conditions de fin et les comportements réellement favorisés par les récompenses.